AIデータセンターでは電力インフラの制約が深刻化しており、計算ノードを増設したくても受電容量の上限に阻まれる事態が珍しくありません。NVIDIAが技術ブログで公開した「DSX MaxLPS」は、参加するハードウェア間で電力を動的に融通し、承認された同一の電力枠のまま運用GPU数を増やす技術です。公開されたGB300 NVL72システムでの共同実測データをもとに、その仕組みと処理性能、導入時に直面する遅延のトレードオフを客観的に整理します。
この記事の結論
NVIDIA DSX MaxLPSは、データセンターの固定された受電電力枠内でGPU間の電力を動的に再配分し、稼働GPU数を増やすソフトウェア技術です。GB300 NVL72での実測では同一電力枠でスループットが49.2%向上した一方、最遅層にあたるP99初回トークン遅延が17%増加するトレードオフも確認されています。
なぜ同じ受電電力のままGPUを約37%増やせるのか?
従来のデータセンター運用では、すべてのノードが同時に最大消費電力に達する最悪のシナリオを想定し、ノードごとに固定の給電枠を確保する「静的プロビジョニング」が一般的でした。この設計は機器の定格超過を防ぐ安全確実な手法である一方、AIワークロードの特性上、大きな電力の余剰マージンを生み出す原因になっています。
AIの処理は一定の電力を消費し続けるわけではありません。大規模言語モデルの学習であれば、計算、通信、ノード間の同期、チェックポイント保存といったフェーズごとに消費電力が激しく変動します。推論処理でも、入力文を処理するプリフィル、1トークンずつ生成するデコード、メモリ帯域を消費する処理、ネットワーク転送、リクエスト待ちのアイドル時間など、状態によって要求電力が大きく上下します。
固定枠で管理されている環境では、あるノードで電力が余っていても、別の高負荷なノードへその電力を融通できません。その結果、受電設備全体としては容量に余裕があるにもかかわらず、安全マージンが障壁となって追加のGPUを電源投入できない「取り残された電力(stranded power)」が発生します。
DSX MaxLPS(Land, Power, Shell constraints:用地・電力・建屋の制約)は、Dynamic Power Softwareを制御層として用い、この未使用電力をリアルタイムに監視して必要な箇所へ再配分します。受電電力そのものを増やすのではなく、決められた上限枠の中で無駄になっていた電力を回収することで、同一の電力バジェット内で最大40%多くのGPU配備を可能にします。アーキテクチャの概要と測定条件は、NVIDIA公式技術ブログの解説記事にて詳細が報告されています。
5つの技術要素が担う電力監視と動的再配分の流れ
DSX MaxLPSの制御ループは、電力供給量を物理的に増やす仕組みではありません。管理対象として設定された電力バジェットの範囲内で、各ハードウェアの電力上限を状況に応じて動的に協調制御するソフトウェア処理です。この制御ループは次の5つの技術要素で構成されています。
第1に、トポロジとリソースグループの構成です。電力会社からの受電設備、変電所、配電盤、ラック、ノード、個別GPUに至る電力供給の階層構造をマッピングし、管理対象のノード群を集約電力バジェットを持つグループとして定義します。
第2に、テレメトリの高速収集です。GPU、ノード、ラック、グループ全体の各レイヤーから電力を高頻度で収集し、利用可能な電力の空き容量(ヘッドルーム)や、急激な電力上昇の兆候を検知します。
第3に、ポリシーの設定です。オペレーターがノードごとの上限値、グループ全体の許容電力、タスクごとの割り当て優先順位、非常用リザーブ、メンテナンス時の挙動ルールをあらかじめ策定します。
第4に、動的な割り当てと制御です。一部のリソースが割り当て電力を下回る負荷で稼働している場合、空いた余力を検知したソフトウェアが、高負荷状態にある他のGPUの電力リミットを一時的に引き上げます。
第5に、検証と執行です。測定された総電力をグループの承認バジェットと常時照合し、消費電力が上限に近づいた際には即座に各ノードのリミットを絞り込んで、電力違反を未然に遮断します。
GB300 NVL72の実測でスループットは約49%向上した
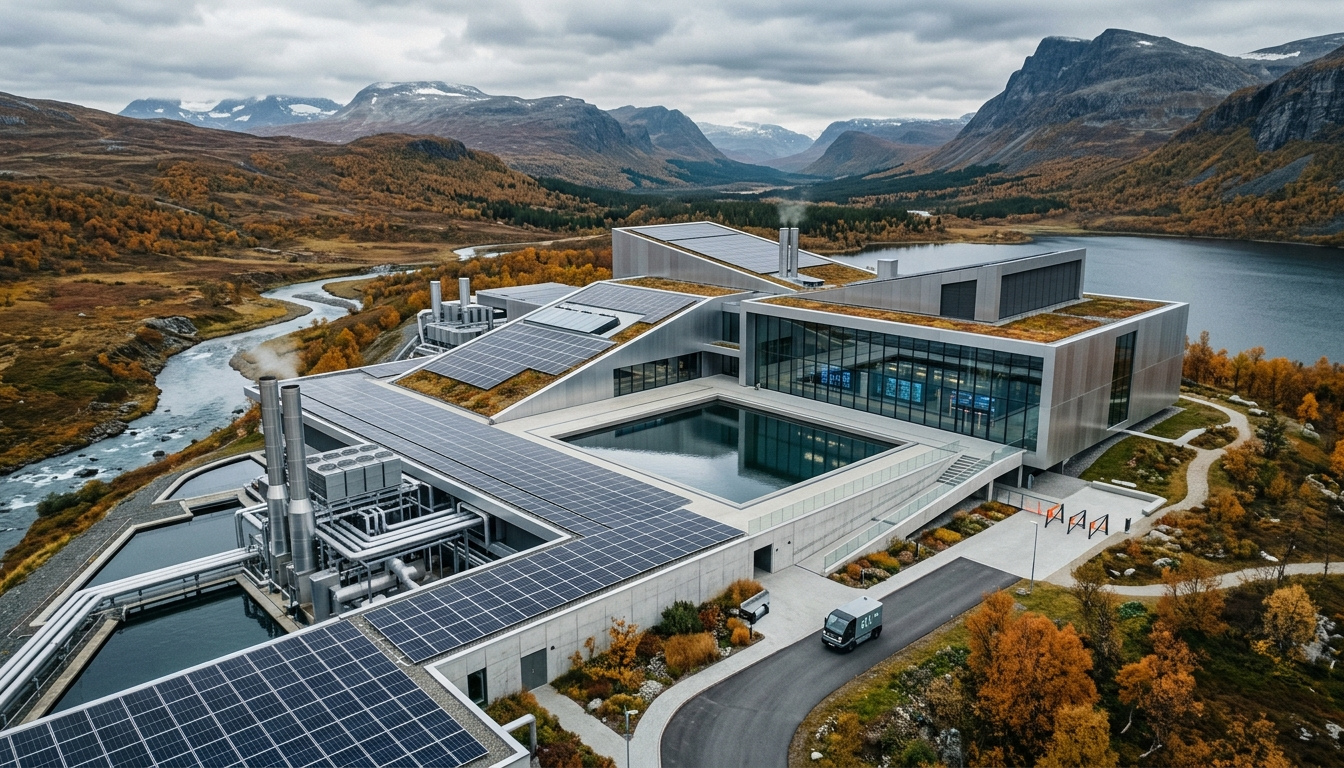
技術の有効性を検証するため、NVIDIAとNscaleはアイスランド・ケプラヴィークにあるVerneキャンパスのデータセンター(全電力を再生可能エネルギーで調達)にて共同評価を実施しました。検証対象にはNVIDIA Blackwell Ultra GPUを搭載したGB300 NVL72システムが採用されています。
テストワークロードにはKimi K2.5モデル(FP4精度)を用い、NVIDIA DynamoおよびNVIDIA TensorRT-LLM上で、入力8Kトークン・出力1Kトークンのシーケンス長を実行しました。実際のデータセンター運用を模すため、大量のリクエストを捌く高スループットインスタンスと、応答性を重視する低遅延インスタンスを組み合わせたワークロード構成となっています。
比較対象となった静的ベースライン環境は、4基のGPUを搭載したノード35台(合計140基のGPU)で構成され、2つの高スループットインスタンス(各52基)と1つの低遅延インスタンス(36基)を稼働させました。対するDSX MaxLPS環境では、同じ電力枠のままノードを48台(合計192基のGPU)へと拡大し、低遅延インスタンス(36基)の割り当てを維持したまま、3つ目の高スループットインスタンス(52基)を追加稼働させています。
| 測定指標 | 静的ベースライン | DSX MaxLPS | 変化率・差分 |
|---|---|---|---|
| 管理GPU数 | 140基 | 192基 | +37.1% |
| 集約スループット | 1,084,503 tokens/s | 1,618,443 tokens/s | +49.2% |
| 高スループット出力(1インスタンスあたり) | 59,153 tokens/s | 59,220 tokens/s | +0.1% |
| 低遅延出力(1インスタンスあたり) | 2,265 tokens/s | 2,265 tokens/s | 0.0% |
| 平均GPU消費電力 | 97.0 kW | 131.8 kW | +35.9% |
| 施設測定総電力 | 166.2 kW | 198.9 kW | +19.7% |
| 電力バジェット利用率 | 62.9% | 75.2% | +12.3ポイント |
| 契約電力1Wあたりスループット | 4.10 tokens/s/W | 6.12 tokens/s/W | +49.2% |
両環境とも、プロビジョニングされた受電電力バジェットは同一の「264.4 kW」に固定されています。この承認電力を分母として算出したワットあたりスループットは、ベースラインの4.10 tokens/s/WからDSX MaxLPSでは6.12 tokens/s/Wへと49.2%向上しました。分母が完全に一致しているため、この数値は集約スループットの純増率と等しくなります。
重要な点は、稼働GPU数を37.1%増やして集約スループットを伸ばしながらも、既存の高スループットインスタンスや低遅延インスタンス単体の処理速度が落ちていない点です。インスタンス単体のトークン生成量はベースラインと同等を維持しており、追加されたGPUが純粋な計算能力の底上げとして機能したことが示されています。
中央値が保たれてもP99遅延が17%悪化する理由
動的な電力配分は効率を高める一方で、物理的な制約を完全に消し去るわけではありません。システム全体の電力上限を厳密に守る以上、局所的なピーク負荷時にはGPUの電力制御が発生するため、サービス遅延に関するトレードオフが生じます。
実測結果によると、処理全体の中央値(Median)および75%のリクエストが含まれるP75遅延については、ベースラインと比較して5%以内の変動に収まりました。一般的なユーザー体験の大部分においては、性能低下が体感されるレベルではありません。
しかし、全体の1%にあたる最も遅いリクエスト群(テール挙動)を示すP99遅延では、明確な影響が観測されています。具体的には、リクエスト送信から最初のトークンが出力されるまでの時間(TTFT:Time to First Token)において、P99の数値が静的ベースラインの15.7秒から17%悪化しました。
この結果は、動的電力融通を導入する際、平均値や中央値の指標だけで性能を評価してはならないことを示しています。ミリ秒単位の応答性が契約(SLA)として定められているミッションクリティカルな推論サービスでは、17%のテール遅延悪化が許容範囲に収まるかどうかを事前に確認しなければなりません。
また、この仕組みが機能する前提として「ワークロードの多様性」が挙げられます。すべてのGPUが同時に全く同一のピーク電力を消費し続ける均一なタスクばかりでは、融通できる空き電力が生じません。推論のプリフィルとデコード、バッチ処理と低遅延処理のように、電力波形が補完し合う関係にある複数のタスクを組み合わせることが、余剰電力を引き出す必須条件となります。
さらに、高精度なテレメトリの存在も不可欠です。電力測定に遅延や欠損、マッピングミスが生じると、誤ったリミット調整により施設全体のバジェット超過や意図せぬ性能低下を招くリスクがあります。実証実験でも、ラック単位の測定値がサイト全体の受電測定値と整合しているかどうかが厳密に突き合わされています。
導入前にオペレーターが検証する5つの段階
データセンターへDSX MaxLPSを導入するにあたり、運用リスクを最小化するための段階的な検証プロセスが提示されています。一度にすべての設定を切り替えるのではなく、次の5段階に沿って検証を進める手順が推奨されています。
第1段階は「管理境界の定義」です。受電盤、変電設備、配電ユニット、ラック、ノード、GPUの物理トポロジを正確にマッピングし、グループ全体の許容電力枠、安全マージンとして残すべきリザーブ要件、異常時のエスカレーション方針を確定します。
第2段階は「代表的なベースラインの確立」です。本番運用で想定されるワークロードの組み合わせを、従来の静的プロビジョニング環境で実際に稼働させます。時間帯による負荷の波や電力のばらつきを把握できる十分な期間、電力と性能のデータを計測します。
第3段階は「保守的なポリシー導入」です。初めから極端なノード追加は行わず、ベースラインに近い安全寄りの制限値からDSX MaxLPSを適用します。テレメトリが正常に届いているか、制御ループが想定通りに応答しているか、総電力が枠内に収まるかを確認します。
第4段階は「容量の段階的追加と負荷試験」です。管理グループ内のノード数を少しずつ増やし、全体の処理スループットとインスタンスごとの応答性を計測します。ピーク負荷時だけでなく、ノードの稼働状態が切り替わる過渡期、テレメトリ通信が一時遮断された場合、給電能力が制限された場合などの異常系テストもこの段階で実施します。
第5段階は「本番運用制限の設定」です。スループットと遅延の目標値をクリアし、電力バジェットと安全リザーブを維持でき、障害時にも予測可能な挙動を示すことが確認できた構成のみを、正式な本番運用パラメーターとして承認します。
Vera Rubin世代の予測とGB300実測値の混同に注意
NVIDIAの解説資料では、将来登場する次世代プラットフォーム「Vera Rubin NVL72」のAIファクトリー構想についても触れられています。そこではDSX MaxLPSの動的電力制御に加えて、45℃の冷却水をそのまま受け入れる高温液冷インフラや、さらなるワットあたり性能向上技術を統合する計画が示されています。
ただし、ここで提示されているVera Rubinに関する数値や展望は将来の予測であり、今回アイスランドで実施されたGB300 NVL72システムの実測値とは性格が異なります。設備投資や運用計画を検討する際には、実測で裏付けられた「GB300における約37%のGPU増設とP99遅延17%増」という事実と、次世代アーキテクチャの将来構想を明確に切り離して評価する必要があります。
DSX MaxLPSは、土地や電力契約の制約から受電枠をこれ以上増やせない既存データセンターにとって、インフラの利用率を劇的に引き上げる現実的な手段です。ただし、魔法のように性能が無償で手に入るわけではなく、テール遅延の増加とテレメトリ基盤の信頼性という運用上の責任が伴います。自社で稼働させるAIモデルのSLA要件と電力特性を見極めた上で、段階的な検証に取り組む姿勢が求められます。
あわせて読みたい関連記事
おすすめ TensorRT Edge-LLMで6.4倍高速化、Jetsonでの成果を検証
NVIDIAハードウェアにおける推論処理の最適化やベンチマーク検証を扱っており、GB300の電力効率やアーキテクチャの検証結果とあわせて理解を深めやすいため。
PR(当サイト運営者のサービス)
コメント